Sentence Transformers v6.0 додає підтримку багатовекторного пошуку Late Interaction
Sentence Transformers v6.0 представляє MultiVectorEncoder для моделей пізньої взаємодії в стилі ColBERT. Збереження векторів окремих токенів замість одного підсумкового вектора покращує якість точного пошуку складних та візуальних запитів.
Чому це важливо
Тепер ви можете розгортати точні пайплайни пошуку ColBERT та ColPali безпосередньо через стандартний Python API Sentence Transformers.
TL;DR
- 01Sentence Transformers v6.0 додає нативну підтримку MultiVectorEncoder для моделей ColBERT та ColPali.
- 02Пізня взаємодія зберігає точність токенового пошуку для складних запитів із кількома умовами.
- 03Квантовані індекси на зразок fast-plaid нівелюють проблему збільшення розміру бази векторів.
Ключові факти
- Середня кількість векторів на текст
- 124.8
- Нестиснений розмір зберігання
- 62 КіБ на текст
- Стиснений індекс (fast-plaid)
- 92 МБ для 608k векторів
Архітектурний перехід до Late Interaction
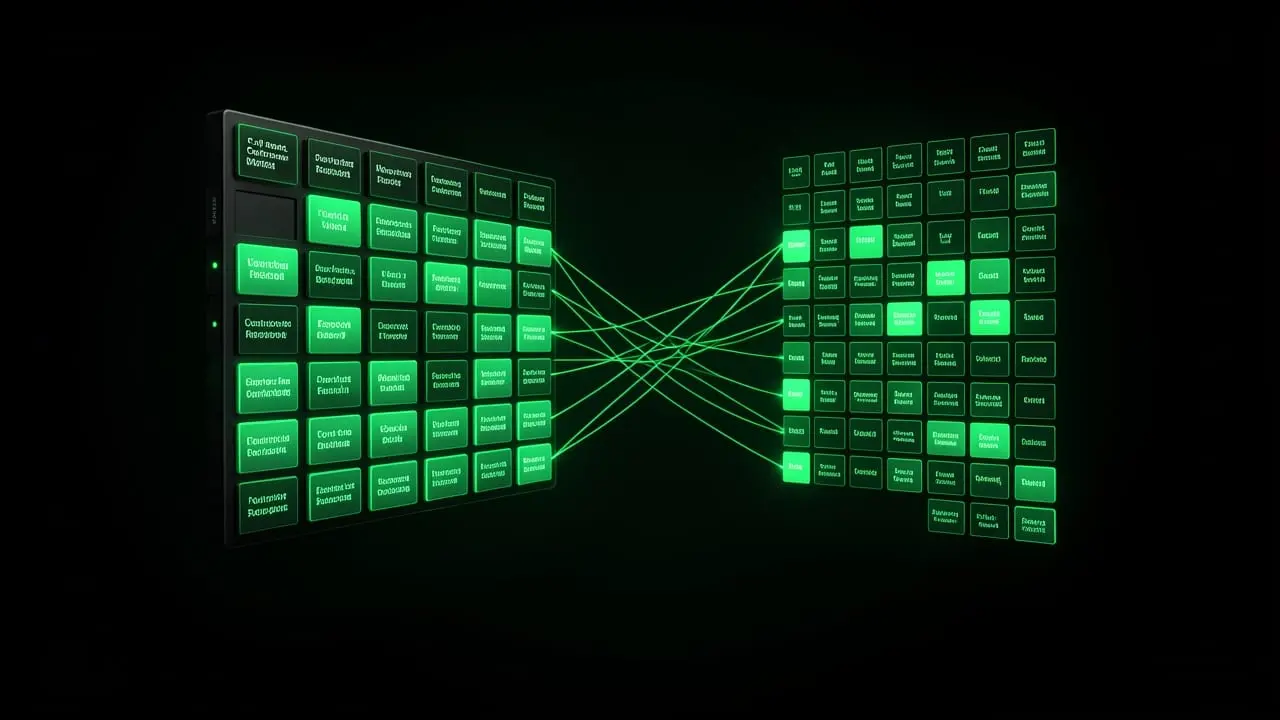
Стандартні двокодувальники стискають фрагменти в один вектор (наприклад, 384 або 768 вимірів). Натомість MultiVectorEncoder зберігає контекст токенів, формуючи матрицю ($N \times 128$ для $N$ токенів). Оцінка запиту виконується оператором MaxSim, який підсумовує максимальні косинусні схожості між токенами запиту та документа.
Розмір індексу та варіанти квантування
Збереження векторів токенів збільшує обсяг індексу. Наприклад, кодування 4 874 фрагментів дає приблизно 608 414 векторів (124.8 векторів на фрагмент, близько 62 КіБ у нестисненому вигляді). Використання квантованих індексів, таких як fast-plaid, зменшує розмір цього ж корпусу до 92 МБ.
Вимоги та сумісність
Sentence Transformers v6.0 вимагає transformers v5.x, torch 2.2+ та huggingface-hub v1.x. Бібліотека підтримує пряме завантаження моделей PyLate, ColBERT та ColPali.
Спробуй за 2 хвилини
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("lightonai/LateOn")
python
✓ Коли використовувати
- Побудова RAG-систем, які вимагають точного збігу сутностей, технічних назв або складних умов запиту.
- Пошук у візуальних документах та сканах сторінок за допомогою ColPali без попереднього OCR.
✕ Коли НЕ варто
- Коли жорсткі обмеження оперативної пам'яті або диска не дозволяють зберігати кілька векторів на документ.
- Якщо звичайні одновекторні етикетки забезпечують достатню точність для коротких запитів.
Що зробити сьогодні
- Оновіть бібліотеку через pip install -U sentence-transformers.
- Протестуйте MultiVectorEncoder на датасетах із точними ідентифікаторами або декількома умовами.
- Оцініть використання fast-plaid або пулінгу токенів для оптимізації пам'яті індексу.